准备模型
你需要 Linux、Python 3.12 或更高版本、uv,以及支持 CUDA 和 BF16 的 NVIDIA GPU。
安装时保留仓库对 Torch、Transformers 和 FlashInfer 的版本约束。在 PhyAI 仓库根目录执行:
config.json、unis.tiktoken 和 unis_vision_tokens.txt。
Emu3.5-VisionTokenizer 目录需要包含配置和模型权重。
文本分词使用的 tiktoken 随 phyai-utils-tools 一起安装。
生成图片
先用nvidia-smi 查看 GPU 是否空闲,再运行:
outputs/u0-teapot/image.png 查看结果。换一个提示词时,修改 --prompt,并为 --output-dir 指定新目录或空目录。
PHYAI_FLASHINFER_WORKSPACE_BYTES=536870912 将 FlashInfer 工作区设为 512 MiB。
默认的 128 MiB 不足以运行这个完整图像配置,估算显存时还要计入模型权重和 KV 缓存。
一张完整图片需要输出 4169 个 token,--max-new-tokens 至少设为这个值。
程序先生成 token 并关闭自回归引擎,再加载图像解码器,两个模型分阶段使用显存。
查看输出
输出目录包含以下文件:
正常完成时,
generation.json 中的 stop_reason 为 "eos",generated_tokens 为 4169。
程序会检查视觉 token 流,再进行图像解码。
检查文本分词
如果只想查看提示词的 token,可以加上--prepare-only,不加载模型权重:
生成样例
以下图片在 NVIDIA Thor 上生成,使用 seed 42、CFG scale 3、FlashInfer 和 PhyAI 原生解码器。 将上面生成命令中的提示词换成对应内容,并分别指定输出目录,即可运行这些样例。陶瓷茶壶
提示词:A studio photograph of a ceramic teapot on a wooden table.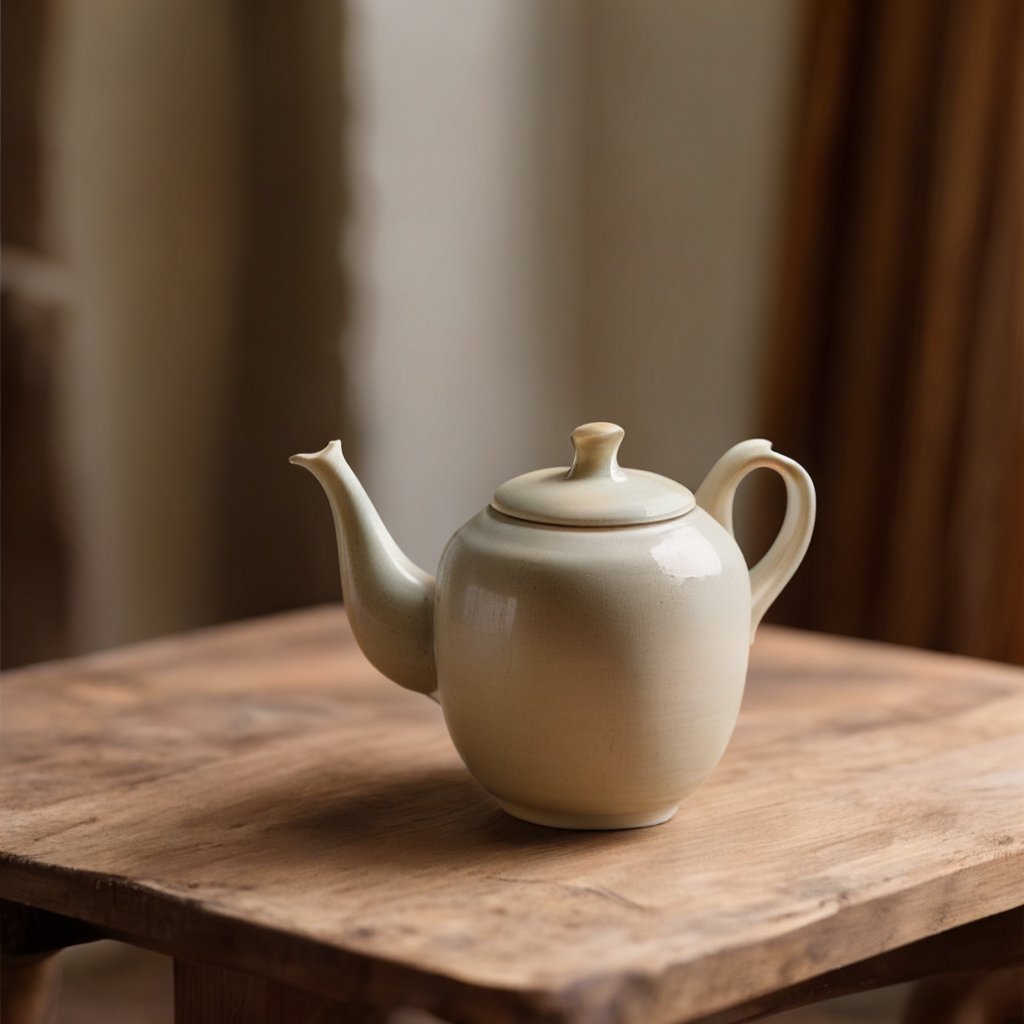
工业相机
提示词:A compact industrial inspection camera on a brushed steel workbench, precise studio lighting.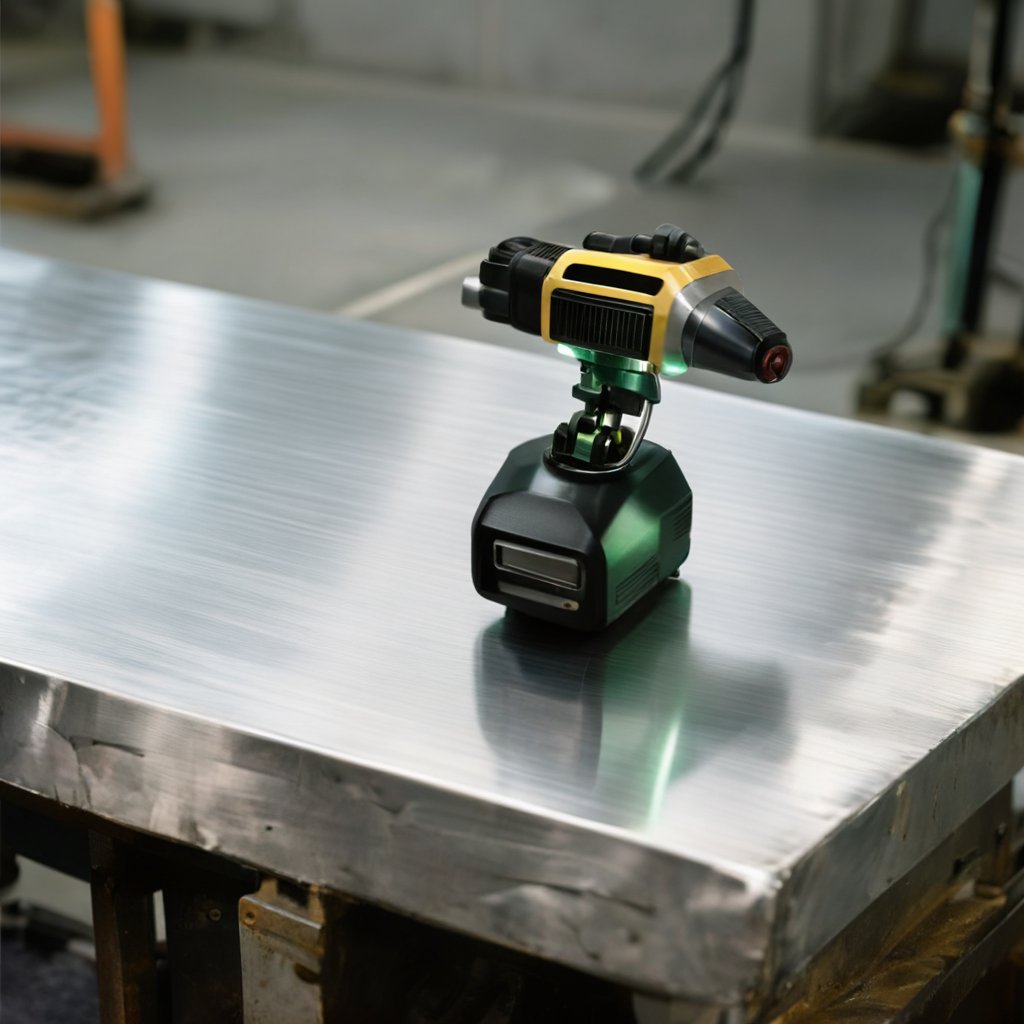
机械夹爪
提示词:A robotic gripper holding a small metal component on an assembly line, realistic industrial photography.