vpp2 插件支持 VPP2
的 RoboDojo、LIBERO 动作策略和独立视频预测。
准备好 PhyAI CUDA 环境和完整的 VPP2 发布目录,
包括 config.json、Wan 资源、tokenizer、模型权重和 dataset_stats.json。
以下命令均在 PhyAI 仓库根目录运行。
动作推理
--image 可以接收一张已合成图像,
也可以按下表顺序接收各相机的图像路径:
输出的
.pt 文件包含 CPU 张量:action 使用 checkpoint 定义的动作单位,
normalized_action 为归一化动作。添加 --return-video 可将完整解码视频
保存到 video_full。动作推理仅支持 guidance scale 1。
历史条件使用 --condition-history 和 --condition-observation,
张量格式见 --help。观测历史和动作执行由调用方管理。
视频预测
video_stage2_17f 生成 17 帧,换成 video_stage1_49f 可生成 49 帧。
两者默认使用 30 步、CFG scale 4。输出包含 video_latents 和解码视频
video;后者形状为 [1, 3, T, H, W],数值范围为 [-1, 1]。
多 GPU
将uv run python 替换为
uv run torchrun --standalone --nproc_per_node=N,再添加对应参数:
进程数必须等于
tp × cfg-parallel。当前不支持 DP、CP 或序列并行。
配置
示例自动选择 kernel 策略,也可用--kernel-config /path/to/policy.yaml 覆盖。
两份 YAML 还选择了归一化、调制和 RoPE 融合 kernel。请使用与推理模式对应的策略。
CUDA graph 默认开启,
--no-cuda-graph 可关闭。首次请求包含图捕获和编译开销。
连续推理应复用同一个 Engine;Python API 和资源释放用法见
examples/vpp2/run_vpp2.py。自行构造 Engine 时,将对应 YAML 通过
KernelConfig(config_path=...) 传入 EngineConfig.kernel。
性能
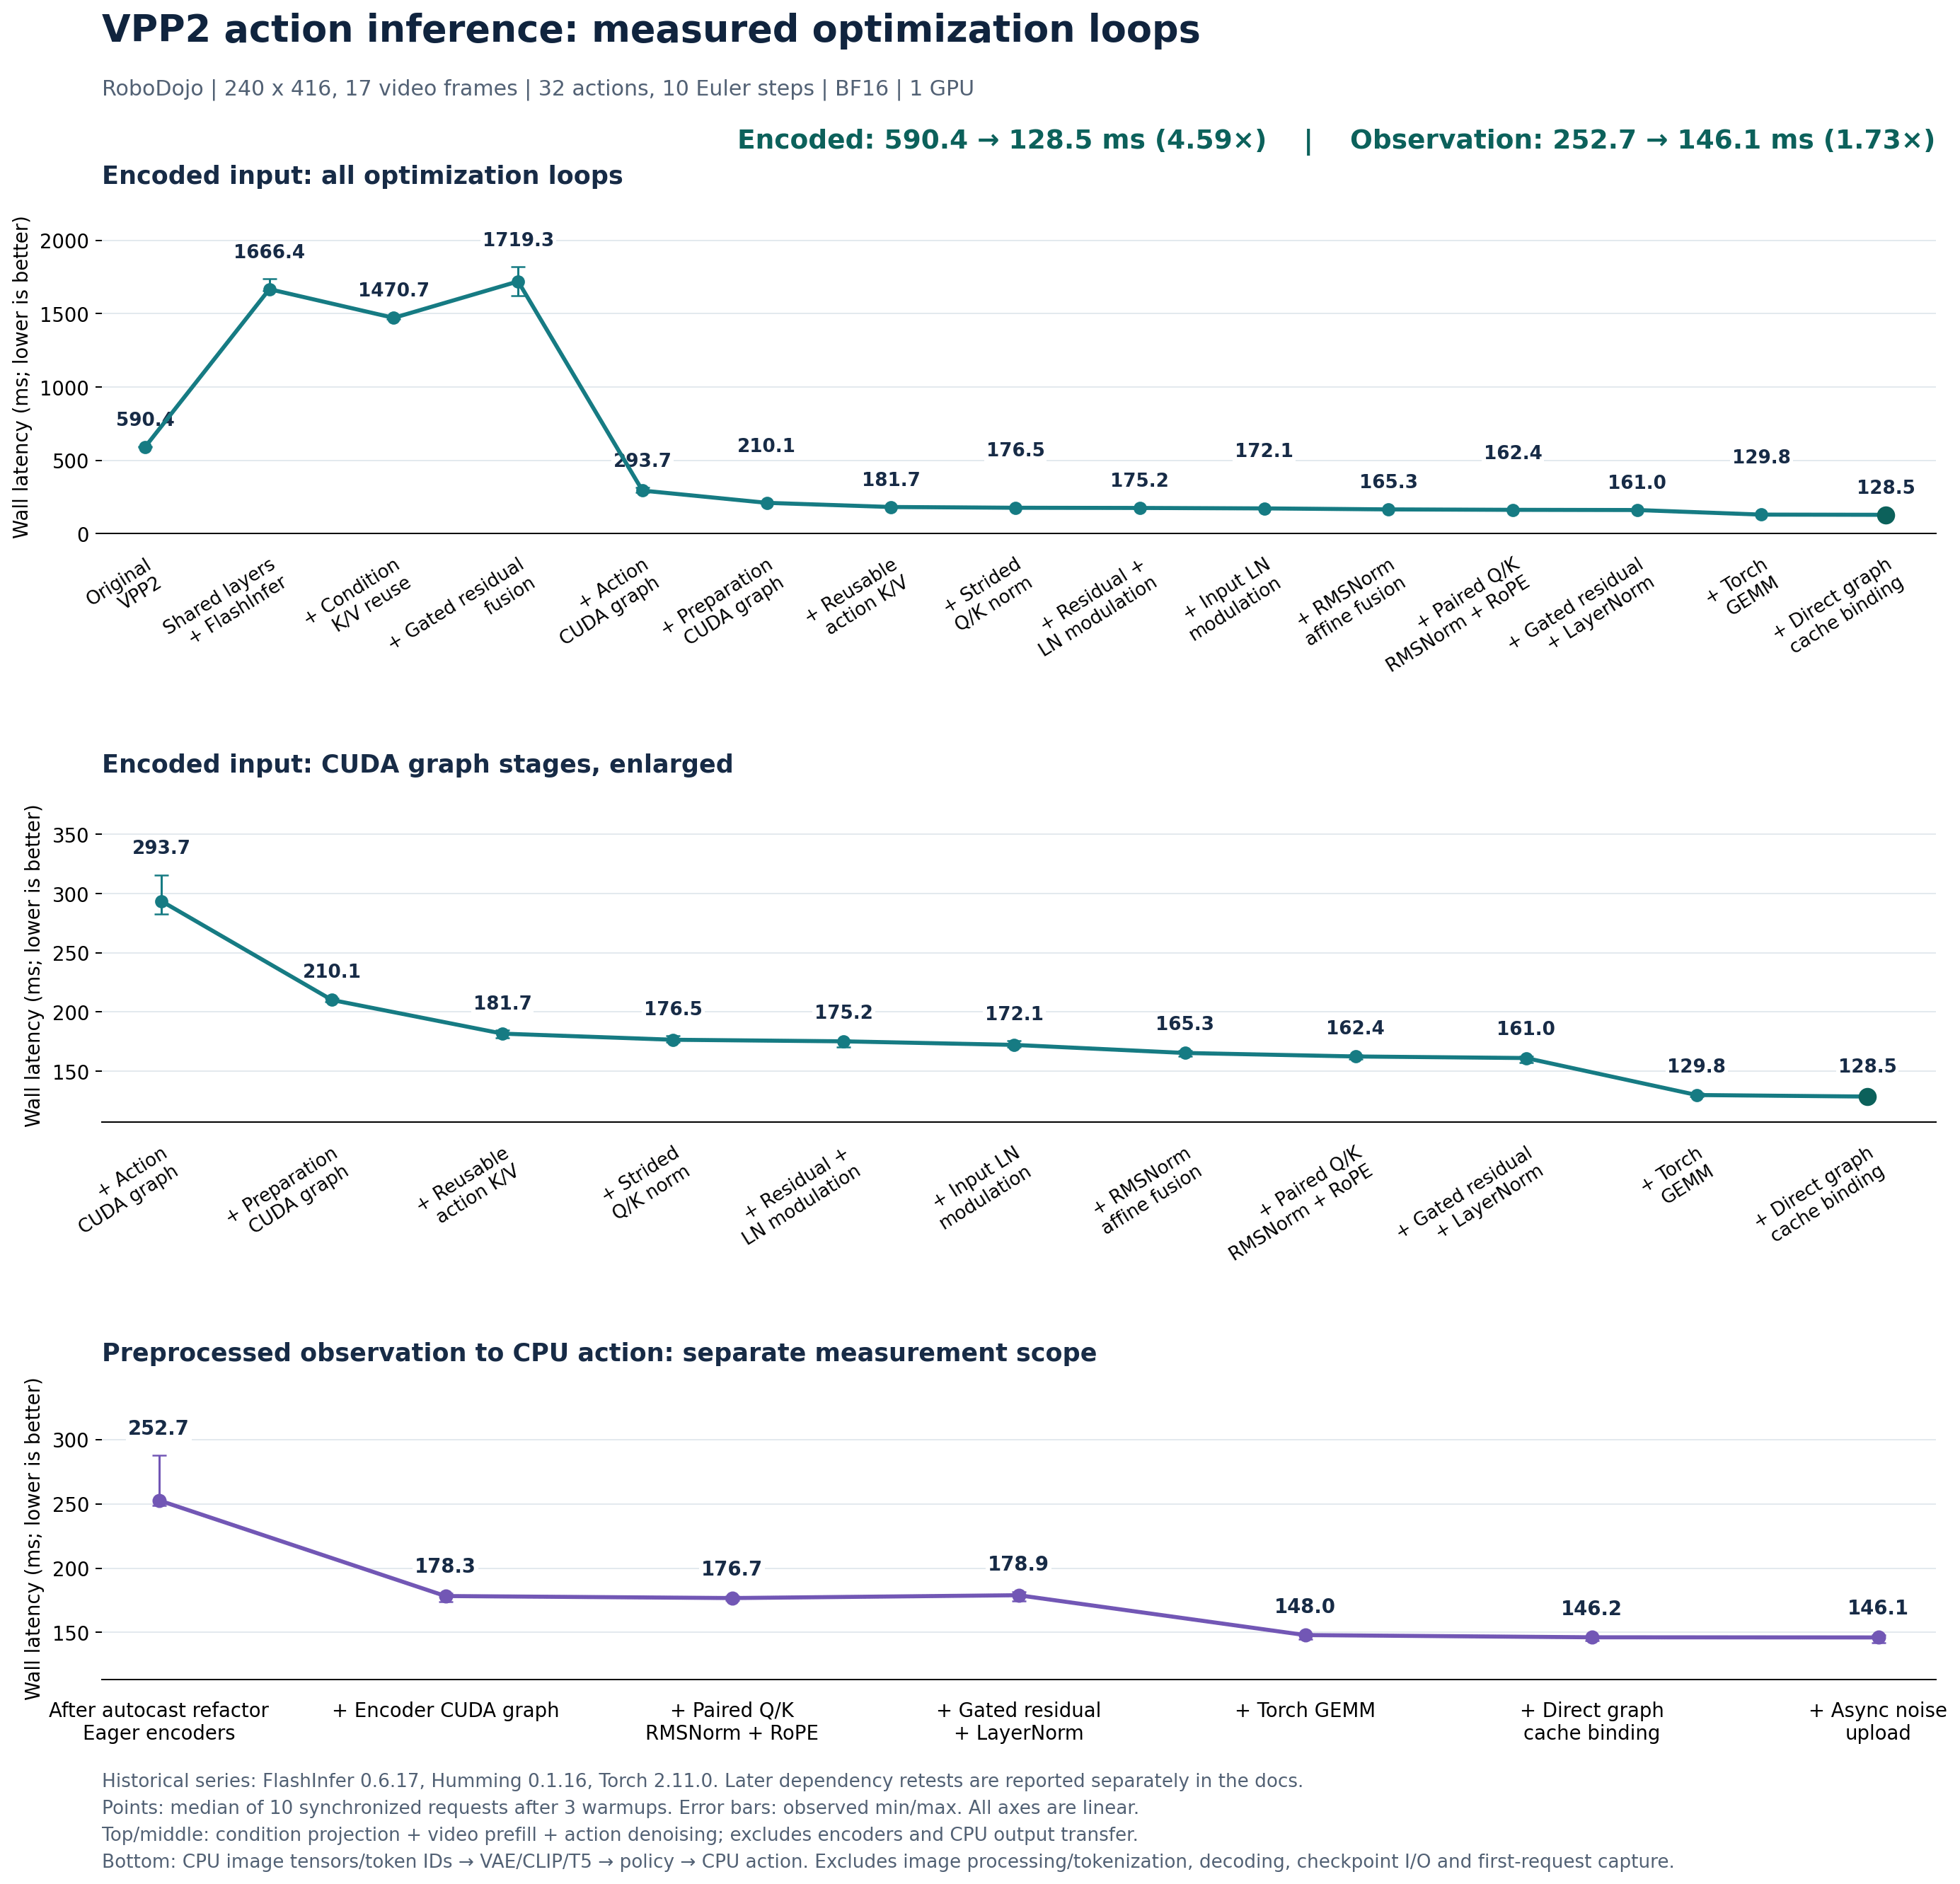
RoboDojo 测试使用单张 NVIDIA H200 GPU、240 × 416 分辨率、17 帧视频、
32 个动作和 10 步 Euler。FlashInfer 0.7.4、Humming 0.1.19 下的结果为:
区间为各轮中位数的范围,每轮预热三次后测量十个请求。计时不包含图像预处理、
分词、权重读取、视频解码及首次请求的图捕获。
下方折线图记录依赖升级前的优化阶段,使用 FlashInfer 0.6.17 和
Humming 0.1.16: